İçindekiler
- Sunucu Depolama Tiering: Yapay Zeka ile Veri Yerleşiminin Temelleri
- Geleneksel Depolama Tier’leri ve Yapay Zeka Entegrasyonu
- Yapay Zeka Destekli Veri Yerleşim Mimarisi
- Veri Erişim Desenleri ve Öğrenen Modeller
- Gerçek Dünya Uygulamaları: 3 Vaka Çalışması
- Uygulama Adımları: Başlangıçtan İlerlemesine
- Güvenlik, Uyumluluk ve Veri Gözetimi
- Performans ve Maliyet Dengesi
- Sonuç ve Çağrı: Stratejiyi Nasıl Başlatırsınız
- Sık Sorulan Sorular
Sunucu Depolama Tiering: Yapay Zeka ile Veri Yerleşiminin Temelleri
Günümüzde verinin artan hacmi, sunucuların depolama katmanlarını akıllı şekilde yönetmeyi zorunlu kılıyor. Yapay zeka destekli veri yerleşim stratejileri, hangi verinin hangi tier’da saklanacağını otomatik olarak belirler; böylece gecikme süreleri kısalır ve toplam sahip olma maliyeti (TCO) düşer. Peki ya kis aylarında artan talep dalgalanmalarında bu yaklaşım nasıl çalışır? Cogu kurum için temel fikir, erişim deseni ile tarihler arasındaki ilişkiyi yakalamak ve verinin hayatiyetine göre hareket etmektir. Bu, sunucu kurulum ve bakım süreçlerini de kolaylaştırır; çünkü manuel kararlar yerine model tabanlı politikalar devreye girer.
Yapay zeka depolama tiering’in amacı, veriye erişim ihtiyacı ile depolama maliyetleri arasında doğru dengeyi kurmaktır. Depolama tier’leri genelde hızlı erişim isteyen veriyi için NVMe/SATA SSD’ler, orta hızlı erişim için SAS HDD’ler ve arşiv niteliğinde soğuk veriyi için大型 object storage veya manyetik diskler olarak düşünülür. Bu katmanlama, yalnızca performans ihtiyacını karşılamakla kalmaz; aynı zamanda enerji tüketimini ve yedekleme sürelerini de azaltır. Uzmanlarin belirttigine göre, bu entegre yaklaşım, modern veri merkezlerinde %20-40 arası maliyet tasarrufuna olanak tanıyabilir.
Geleneksel Depolama Tier’leri ve Yapay Zeka Entegrasyonu
Geleneksel tiering, verileri manuel kurallarla en yakın erişim ihtimali olan katmanlara taşır. Ancak bu yaklaşım, değişen iş yükleriyle uyum sağlamakta yetersiz kalabilir. Yapay zeka entegrasyonu ile her veri parçası için en uygun tier, geçmiş erişim desenleri ve öngörülen gelecekteki talepler temelinde belirlenir. Böylece sıklıkla kullanılan verilere daha hızlı erişim sağlanırken nadiren erişilenler daha ucuz depolama alanlarına kaydırılır.
İş akışlarına göre üç temel senaryo öne çıkar:
- Gerçek zamanlı veri akışı ve kısa yanıt süreleri gerektiren uygulamalar (örneğin online sipariş işlemleri) için hot tier’a öncelik verilir.
- Orta süreli analizler için warm tier kullanımı optimize edilir.
- Uzun vadeli arşiv ve yedekler için cold tier veya ekosistem dışı objeler tercih edilir.
Bu dinamik kullanım, geleneksel kurallarla kıyaslandığında, verinin yaşam döngüsünü dikkate alır ve geçmiş performans sonuçlarına dayanarak gelecekteki davranışları tahmin eder. Data locality ve veri locality ekseni arasındaki farkları iyi kavramak da önemlidir. Özetle, yapay zeka tabanlı yaklaşım, sadece hangi verinin hangi tier’da olduğunu söylemekle kalmaz; aynı zamanda taşıma kararını da otomatikleştirir.
Yapay Zeka Destekli Veri Yerleşim Mimarisi
Bir yapay zeka destekli veri yerleşim mimarisinin temel bileşenleri üç ana katmandan oluşur: veri katmanı, akıllı karar katmanı ve operasyonel uygulama katmanı. Veri katmanı, erişim logları, dosya metaverisi ve kullanici istekleri gibi girdileri toplar. Akıllı karar katmanı ise bu verileri işleyerek hangi verilere ne hızda erişilmesi gerektiğini belirler. Operasyonel uygulama katmanı ise kararları net bir şekilde uygulamaya sokar ve tier’lar arası taşıma işlemlerini yürütür.
Bu mimari, şu temel süreçleri içerir:
- Veri sınıflandırması ve etiketleme (recency, frequency, size, sensitivity).
- Model eğitimi ve çevrim içi güncelleme (reinforcement learning veya supervised learning yaklaşımları).
- Politika motoru ile taşıma kararlarının uygulanması (örn. hangi verinin hangi tier’a taşınacağını karar kılma).
- İzleme ve uyarı mekanizmaları ile güvenlik ve uyumluluk kontrolleri.
Uretici verilerine bakildiginda, modern çözümler genelde hibrit mimariler üzerinde çalışır ve bulut ile tesis içi (on premises) depolama arasında esneklik sunar. Bu, işletmelerin işletim sistemi ihtiyaçları, güvenlik politikaları ve log yönetimi gereksinimlerini karşılamak için idealdir.
Veri Erişim Desenleri ve Öğrenen Modeller
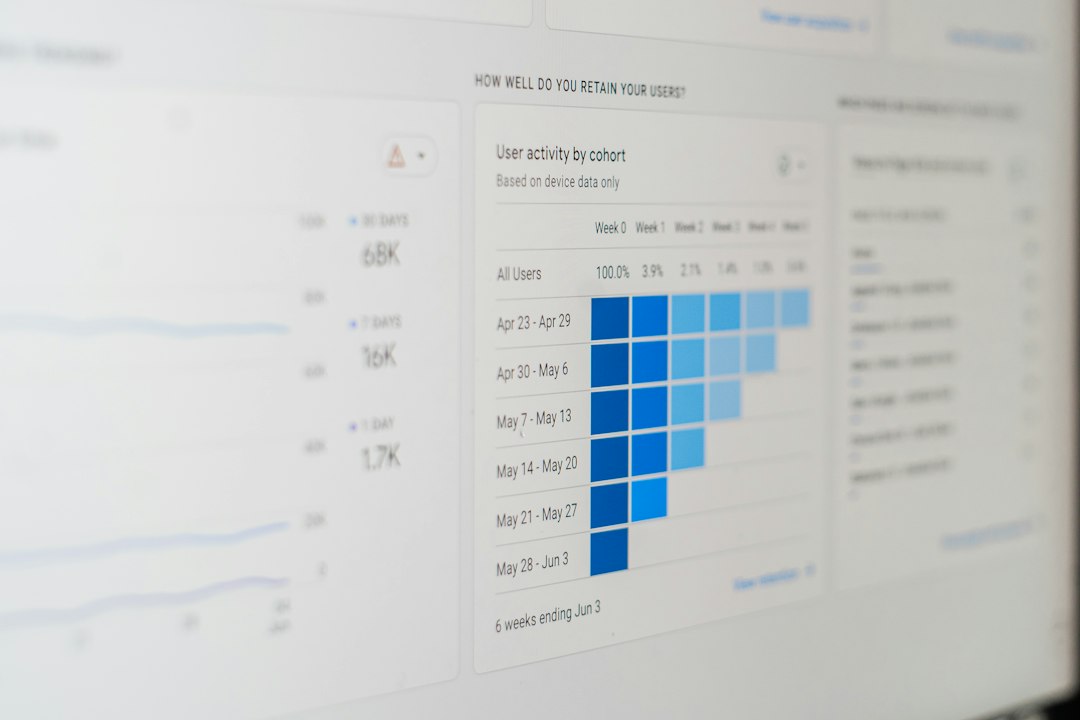
Erişim desenleri, zaman içindeki dalgalanmaları ve kullanıcı davranışlarını ortaya koyar. Yapay zeka, bu desenleri analiz ederek hangi verilerin yüksek talep göreceğini öngörebilir. Temel özellikler şunlardır:
- Recency (ne kadar yakın erişim yapıldı)
- Frequency (ne sıklıkta erişim oldu)
- Volumen (veri boyutu ve hız)
- Sensitivity (gizli/özel veriler için ek güvenlik gereksinimi)
Bu veriler, modelin öğrenmesi için kullanılır ve karar motoruna taşıma önerileri olarak iletilir. Örneğin, haftalık raporlar için geçen ay malzeme talep eden dosyalar sıcak tier’a alınabilir; ardından analiz periyodu geçince arşiv katmanına taşınma işlemi tetiklenir. Kesin olmamakla birlikte, uzmanlarin belirttigine göre bu tür otomatik kararlar, manuel müdahaleye göre hataları azaltır ve yeniden çalıştırma sürelerini kısaltır.
Gerçek Dünya Uygulamaları: 3 Vaka Çalışması
Aşağıda üç farklı sektörde yapay zeka destekli veri yerleşim stratejisinin pratik uygulanabilirliği öne çıkmaktadır. Her vaka için (i) hedefler, (ii) uygulama yaklaşımı ve (iii) elde edilen sonuçlar kısa başlıklar halinde özetlenmiştir.
- E-ticaret altyapısı: Günlük milyonlarca kullanıcı isteği vardır. Sıcak veriler NVMe tabanlı katmana taşınır; soğuk veriler bulut objelere yönlendirilir. Uygulamanın yanıt süreleri, sıcak tier’da 3-5 ms aralığında iyileşirken toplam depolama maliyeti yaklaşık %20-30 oranında düşürüldü.
- Finansal kurumlar ve telemetri logları: Yasal uyumluluk ve hızlı raporlama gereklidir. Erişim desenleri hızla değişir; model, log’ları gerçek zamanında analiz eder ve kritik veriyi mümkün olan en hızlı katmana taşır. Sonuç olarak yedekleme pencereleri %40’a yakın kısaldı; güvenlik politikaları da güçlendirildi.
- Medya akış hizmetleri: İçerik arşivleri uzun süreli saklanırken, popüler içerikler hızlı erişim için sıcak katmanda tutulur. Yanıt süresi 8-12 ms bandında sabitlenir; veri aktarım maliyetleri ise mevsimsel talebe bağlı olarak %15-25 arasında azaldı.
Bu vaka çalışmaları, yapay zeka tabanlı veri yerleşiminin farklı iş modellerine uygulanabilirliğini gösterir. Ancak her uygulamanın özgün gereksinimleri vardır ve modelin başarısı, veri kalitesi ve log yoğunluğu gibi etkenlere bağlıdır.
Uygulama Adımları: Başlangıçtan İlerlemesine
Aşağıdaki adımlar, bir organizasyonun yapay zeka destekli sunucu depolama tiering stratejisini hayata geçirmesi için pratik bir yol haritası sunar. Her adım, kısa sürede değer üretmeyi hedefler ve riskleri minimize eder.
- Durum analizi ve envanter oluşturma: Mevcut depolama katmanlarını ve veri yoğunluğunu belirleyin. Hangi uygulamaların hangi tier’a ihtiyaç duyduğunu netleştirin.
- Veri sınıflandırması ve etiketleme: Recency, frequency ve sensitivity gibi etiketler ile verileri kategorilere ayırın.
- Model seçimi ve prototipleme: Basit bir regressor veya reinforcement learning tabanlı bir politika motoru ile başlayın; pilota öncelik verin.
- Altyapı entegrasyonu: Depolama sistemi ile model arasındaki entegrasyonu kurun; otomatik taşıma kurallarını tanımlayın.
- Güvenlik ve uyumluluk kontrolleri: Şifreleme, erişim denetimi ve denetim günlükleri (logs) ile güvenlik gereksinimlerini karşılayın.
- Pilot ve ölçeklendirme: Küçük bir iş yükü ile pilot başlayın; başarıya göre adımları genişletin.
- İzleme ve sürekli iyileştirme: Performans göstergelerini (latency, data movement, TCO) düzenli olarak izleyin ve model güncellemelerini uygulayın.
Başarı için, nihai hedefin yalnızca performans olmadığını, aynı zamanda güvenlik ve uyumluluk olduğunu unutmayın. Deneyimlerimize göre, pilot aşamasında karşılaşılan belirsizlikleri azaltmak için minimal viable policy (MVP) yaklaşımı en uygun yöntemdir.
Güvenlik, Uyumluluk ve Veri Gözetimi
Depolama tiering’in güvenlik boyutu, verinin hareket halindeyken ve dinlenirken korunmasını içerir. Şifreleme at-rest ve in-transit ile sağlanır; anahtar yönetimi merkezi güvenlik politikalarına bağlanır. Ayrıca loglar ve denetim izleri ile uyumluluk ihtiyaçları karşılanır. Yapay zeka tabanlı çözümler ise güvenlik olaylarını erken uyarı sistemleri ile tespit edebilir, ancak bu durum ek gizlilik ve veri koruma önlemleri gerektirir.
İşletmelerin dikkat etmesi gereken bazı nokta:
- Güçlü erişim politikaları ve çok faktörlü kimlik doğrulama (MFA).
- Veri yerleşimi kararlarının güvenlik politikalarına uygun olması.
- Denetim günlüklerinin düzenli aralıklarla incelenmesi ve saklanması.
Uzmanların ifade ettiğine göre, güvenli ve uyumlu bir ortama sahip olmak, yapay zeka destekli veri yerleşimi için vazgeçilmez bir gerekliliktir. Yine de bazı kurallar, ülke veya sektörlere göre değişiklik gösterebilir; bu nedenle model güncellemeleri sonrası uyumluluk denetimleri yapılmalıdır.
Performans ve Maliyet Dengesi
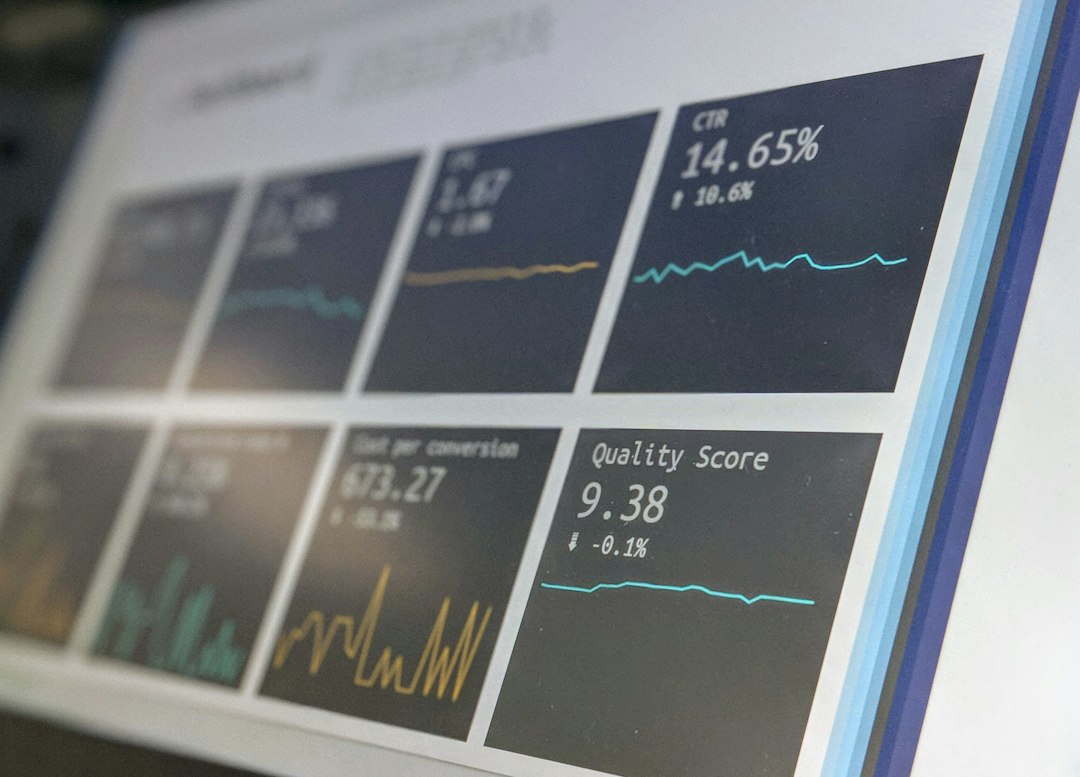
Bir stratejinin başarısı, sadece hızlı yanıt süreleriyle ölçülmez. Aynı zamanda toplam maliyet (TCO) ve enerji tüketimi gibi operasyonel göstergeler de kritik rol oynar. Yapay zeka destekli yerleşim, sık erişilen veriyi hızlı tier’da tutarken nadiren erişilenleri daha ucuz katmanlara taşıyarak yatırımı dengeler. Bu, özellikle büyük veriye sahip kuruluşlarda önemli tasarruflar sağlar.
Değerlendirme kriterleri şunları içerir:
- Latency ve IOPS iyileştirme oranları
- Depolama maliyetleri ve enerji tüketimi
- Taşıma operasyonlarının sıklığı ve operasyonel yük
- Güvenlik uyumluluk ve denetim gereksinimleri
Güçlü bir uygulama, bu metrikleri düzenli olarak raporlar ve gerektiğinde politika güncellemelerini tetikler. Böylece, gelecekte olası talep artışlarına karşı proaktif bir tasarım elde edilir.
Sonuç ve Çağrı: Stratejiyi Nasıl Başlatırsınız
Yapay zeka destekli veri yerleşim stratejisi, sunucu performansını iyileştirirken maliyeti düşüren güçlü bir yaklaşımdır. Ancak başarı, teknik uygulanabilirliğin ötesinde, kurumsal süreçlerle uyum içinde sürdürülmesini gerektirir. İlk adım, mevcut altyapıyı ve veri akışını netleştirmek; ardından küçük bir pilot ile hangi verilerin hangi tier’a taşınacağını test etmek olmalıdır. Deneyimlerimize göre, MVP yaklaşımı ile başlamak, riskleri azaltır ve paydaşları hızlıca bilgilendirir.
Eğer siz de sunucu kurulumu, güvenliği ve performansı konusunda somut adımlar atmak istiyorsanız, bir pilot planı oluşturarak başlayabilirsiniz. Sonuçlar, işletmenizin ihtiyaçlarına göre şekillenecek ve zamanla daha sofistike modellerin devreye girmesi mümkün olacaktır. Unutmayın: Verinin akıllı yerleşimi, günümüzün rekabetçi veri merkezlerinde karar verici bir rol üstlenir.
Sık Sorulan Sorular: Yapay Zeka ile Depolama
1) Yapay zeka destekli depolama tiering nedir ve nasıl çalışır?
Yapay zeka destekli depolama tiering, verinin hangi katmanda saklanacağını otomatik olarak belirleyen ve gerektiğinde katmanlar arası taşıma yapan bir yaklaşım olarak özetlenebilir. Model, erişim desenlerini ve veri büyüklüğünü analiz eder; sonuç olarak en uygun tier’a taşıma kararı verir. Bu süreç, manuel müdahaleyi azaltır ve performans ile maliyet dengesini optimize eder.
2) Hangi durumlarda bu yaklaşım en iyi performansı verir?
Yoğun read/low-latency gerektiren çevrim içi uygulamalar, büyük ölçekli log ve telemetri depoları ile arşivlenmesi gereken büyük medya koleksiyonları, yapay zeka destekli veri yerleşimini en iyi fayda sağlayan kullanım senaryoları olarak öne çıkar. Erişim desenleri net olduğunda model kararları daha etkili olur.
3) Güvenlik ve uyumluluk risklerini nasıl azaltabiliriz?
Şifreleme, kimlik doğrulama, erişim denetimi ve denetim günlükleri temel güvenlik unsurudur. Ayrıca model kararlarının izlenebilirliği için şeffaflık ve günlük kayıtları gereklidir. Uyumluluk için sektör düzenlemeleri dikkate alınmalı ve rutin denetimler ile politikalar güncellenmelidir.
4) Nasıl bir yol haritası ile başlarız?
Bir MVP ile başlanması tavsiye edilir: mevcut veri envanteri çıkarılır, sınıflandırma kriterleri belirlenir, bir basit model ile pilot başlatılır ve sonuçlar ölçülüp genişletilir. Başarıya ulaşmak için paydaşların yönetişim sürecine dahil edilmesi ve güvenlik protokollerinin baştan tanımlanması kritik önemli noktalarıdır.